Modelos & Chatbots · Modelos Locales y Privados
Dato clave verificado: 8B–70B (guía de memoria real)
Tiempo de lectura: 8 min · Incluye esquema visual y plantilla probada
Guía de compra clara sin tecnicismos: cuánta memoria VRAM o unificada necesitas para correr modelos de IA de 8B, 14B, 32B y 70B en PC o Mac sin gastar de más.
Modelos & Chatbots · Modelos Locales y Privados
Dato clave verificado: 8B–70B (guía de memoria real)
Tiempo de lectura: 8 min · Incluye esquema visual y plantilla probada
Vas a una tienda de informática a preguntar por un ordenador para usar Inteligencia Artificial en local y el vendedor intenta colocarte el procesador más caro de la tienda y un disco duro enorme... cuando en realidad el 95% de la velocidad de la IA depende de un único dato que casi nadie mira al comprar: la cantidad de memoria de vídeo (VRAM) de la tarjeta gráfica o la memoria unificada si es un Mac. Comprar sin saber esta regla tan simple puede hacerte tirar mil euros a la basura.
En esta guía práctica te explicamos en cristiano qué mirar exactamente antes de comprar o ampliar tu equipo, y qué modelos podrás mover con fluidez según los gigabytes de memoria que tengas.
Hemos estructurado este artículo paso a paso y sin tecnicismos innecesarios para que puedas leerlo de principio a fin o ir directo al punto que necesites:
Imagina que estás cocinando a toda velocidad:
La memoria VRAM de tu tarjeta gráfica es la encimera que tienes justo delante de tus manos. Si todos los ingredientes caben encima de la encimera, cocinas rapidísimo (la IA escribe entre 30 y 80 palabras por segundo).
Pero si el modelo de IA es más grande que tu encimera, tu ordenador tiene que dejar la mitad de los ingredientes en la RAM normal o en el disco duro (como tener que bajar corriendo las escaleras hasta el trastero por cada cucharada de sal). ¿El resultado? En cuanto el modelo supera la memoria de tu tarjeta gráfica, pasa de responder al instante a escribir una palabra cada tres segundos.
En un PC tradicional con Windows o Linux, la memoria del ordenador (RAM) y la memoria de la tarjeta gráfica (VRAM) van por separado: puedes tener 64 GB de RAM, pero si tu tarjeta gráfica solo tiene 8 GB de VRAM, tu límite rápido son esos 8 GB. En cambio, los ordenadores Mac con chips Apple Silicon (M1, M2, M3, M4) usan Memoria Unificada: su tarjeta gráfica puede usar casi toda la memoria RAM del equipo, permitiendo que un Mac Mini o Mac Studio con 36 GB o 64 GB de RAM cargue modelos enormes que no caben en una tarjeta gráfica doméstica de PC.
Para que tengas todas las cifras oficiales de un solo vistazo sin tener que buscar en diez páginas distintas, aquí tienes la comparativa actualizada:
| Modelo | Ideal para | Ventana Contexto | Precio API Oficial (1M In/Out) | Fuente / Acceso |
|---|---|---|---|---|
| DeepSeek R1 / V3 | Razonamiento Abierto (MIT) y Ahorro API | 128.000 tokens | $0.55 / $2.19 (R1) | Ver oficial ↗ |
| Claude 3.7 Sonnet | Razonamiento Híbrido, Código y Redacción | 200.000 tokens | $3.00 / $15.00 | Ver oficial ↗ |
| OpenAI GPT-4o / o3 | Voz en Tiempo Real, Visión y Lógica | 128k – 200k tokens | $2.00 / $8.00 (o3) | Ver oficial ↗ |
| Google Gemini Pro | PDFs de 800 páginas y Vídeo Largo | 2.000.000 tokens | $1.25 / $5.00 | Ver oficial ↗ |
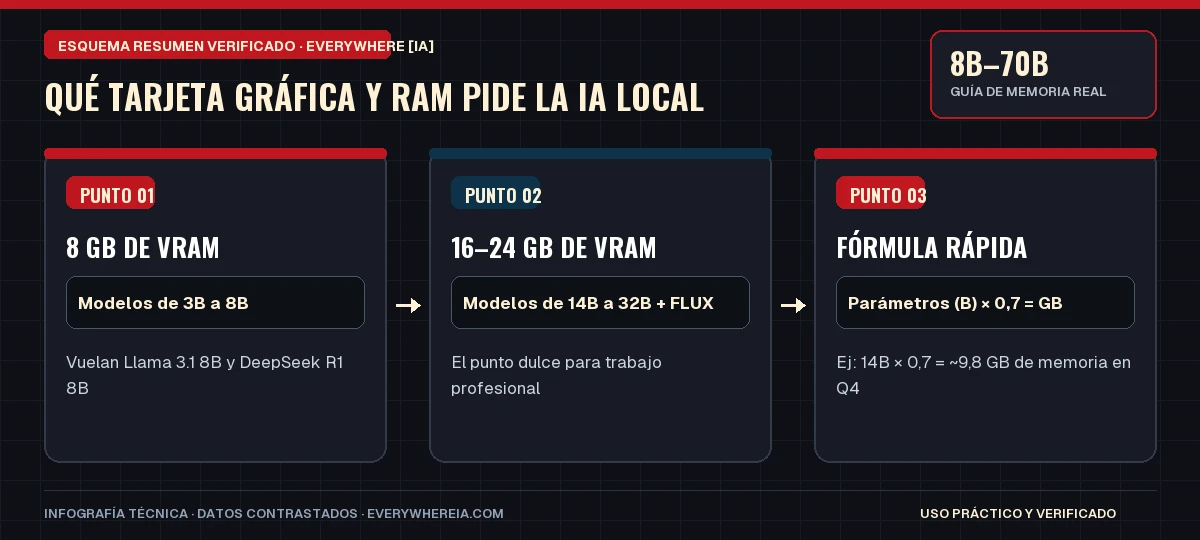
Si descargas modelos cuantizados en el formato estándar Q4_K_M, aplica esta cuenta rápida: toma el número del modelo (por ejemplo, 14B) y multiplícalo por 0,7. 14 × 0,7 = 9,8 GB de memoria necesaria (contando el modelo y un margen para la conversación). Si tu tarjeta tiene 12 GB, cabrá de sobra.
Hemos pre-rellenado esta plantilla con datos de ejemplo reales para que puedas probarla ahora mismo con un solo clic y comprobar que funciona a la primera sin dar ningún fallo:
Actúa como un especialista en hardware para Inteligencia Artificial local.
Dime exactamente qué modelos de lenguaje (en Ollama) y de imagen puedo ejecutar con fluidez en este ordenador (puedes usar estos datos de ejemplo o los míos):

MI EQUIPO ACTUAL:
- Sistema: PC con Windows 11
- Memoria RAM del sistema: 32 GB
- Tarjeta gráfica (GPU): NVIDIA RTX 4060 con 8 GB de memoria VRAM.

RESPONDE DE FORMA CLARA:
1. Qué tamaño máximo de modelo en formato Q4_K_M cabe entero dentro de mis 8 GB de VRAM para que vaya ultrarrápido.
2. Los 3 mejores modelos actuales que me recomiendas instalar hoy con su comando exacto de Ollama.
3. Qué ocurriría con la velocidad si intento abrir un modelo gigante de 70B en este equipo.
Prueba primero con el ordenador que ya tienes instalando un modelo de 8B en Ollama. Y si decides comprar equipo dedicado para IA local, prioriza siempre gigabytes de VRAM (en NVIDIA) o Memoria Unificada (en Mac) por encima de todo lo demás.
Para profundizar directamente en la documentación técnica, comprobar tarifas en tiempo real o descargar las herramientas oficiales mencionadas en este estudio, consulta estos recursos de referencia:
La memoria VRAM de la tarjeta gráfica (o la memoria unificada en un Mac) es diez veces más determinante. Un modelo que cabe entero en la VRAM va rapidísimo aunque el procesador sea normal.
Sí, con modelos ligeros de 3B o 7B parámetros (como Llama 3.2 3B). Irán un poco más despacio porque usarán el procesador y la RAM normal, pero funcionan perfectamente para redactar y resumir.
Modelos IA
Modelos IA · Comparativas (ChatGPT vs Claude)
-96% coste API real
+159K lecturas en 7 díasModelos IA
Modelos IA · Comparativas (ChatGPT vs Claude)
70.3% SWE-bench Verified
+35.7K lecturas en 7 díasModelos IA
Modelos IA · Guías de Modelos y Tokens
-65% ahorro de memoria VRAM
+7.1K lecturas en 7 díasModelos IA
Modelos IA · Modelos Locales y Privados
0€ / mes 100% privado local
+2.8K lecturas en 7 días